Pedir con precisión y verificar lo que devuelve el agente
Lo que más rinde con un agente no es programar: es pedir con precisión y revisar el resultado con criterios escritos antes de aceptarlo. Un método para probar.
Le pides algo a un agente de IA. Te devuelve un texto prolijo en diez segundos. Y ahí empieza el problema: no sabes si lo que pediste era lo que necesitabas, ni si lo que volvió está bien.
Mucha gente cree que para trabajar con un agente hay que saber programar. Mi tesis es otra: lo que más rinde son dos habilidades que un Gestor ya tiene de sobra —decir con precisión qué quiere y revisar lo que le entregan antes de aceptarlo—.
Al terminar vas a poder escribir un pedido que otra persona (o un agente) no pueda malinterpretar, y una lista corta de criterios para aceptar o rechazar el resultado antes de usarlo.
El pedido que no entiende ni un colega
Piensa en el último encargo que le diste a alguien que acababa de llegar al equipo. Si le dijiste «armame un resumen de esto» y nada más, lo más probable es que volviera con preguntas: para quién, de qué largo, qué dejo afuera, qué te importa de verdad. Con un agente pasa lo mismo, solo que el agente rara vez pregunta: rellena.
La guía de prompting de Anthropic lo plantea con una imagen que cualquier jefe de equipo reconoce: tratar al modelo como «un empleado nuevo y brillante» que no conoce tus normas ni tus flujos de trabajo. Y propone una prueba concreta: muéstrale el pedido a una persona sin contexto; si esa persona se confundiría, el modelo también [C1]. Es una práctica publicada por quien hace la herramienta, no un estudio controlado: sirve como método, no como prueba de que el método funcione.
Para tener algo más que una recomendación del proveedor, hay una observación independiente. Nielsen Norman Group hizo un estudio de diario con 18 personas que usaban chatbots y analizó 425 conversaciones. Los pedidos sin componentes —por ejemplo, una consulta corta al estilo de un buscador— resultaron ineficientes: terminaban en conversaciones largas donde el usuario iba aclarando de a poco lo que quería [C2]. Es una muestra chica, cualitativa, con herramientas de 2023. No permite decir cuánto mejora nada. Permite decir algo más modesto y útil: el patrón de «pedir poco y corregir mucho» existe y se puede ver.
Cuatro partes que ya conoces
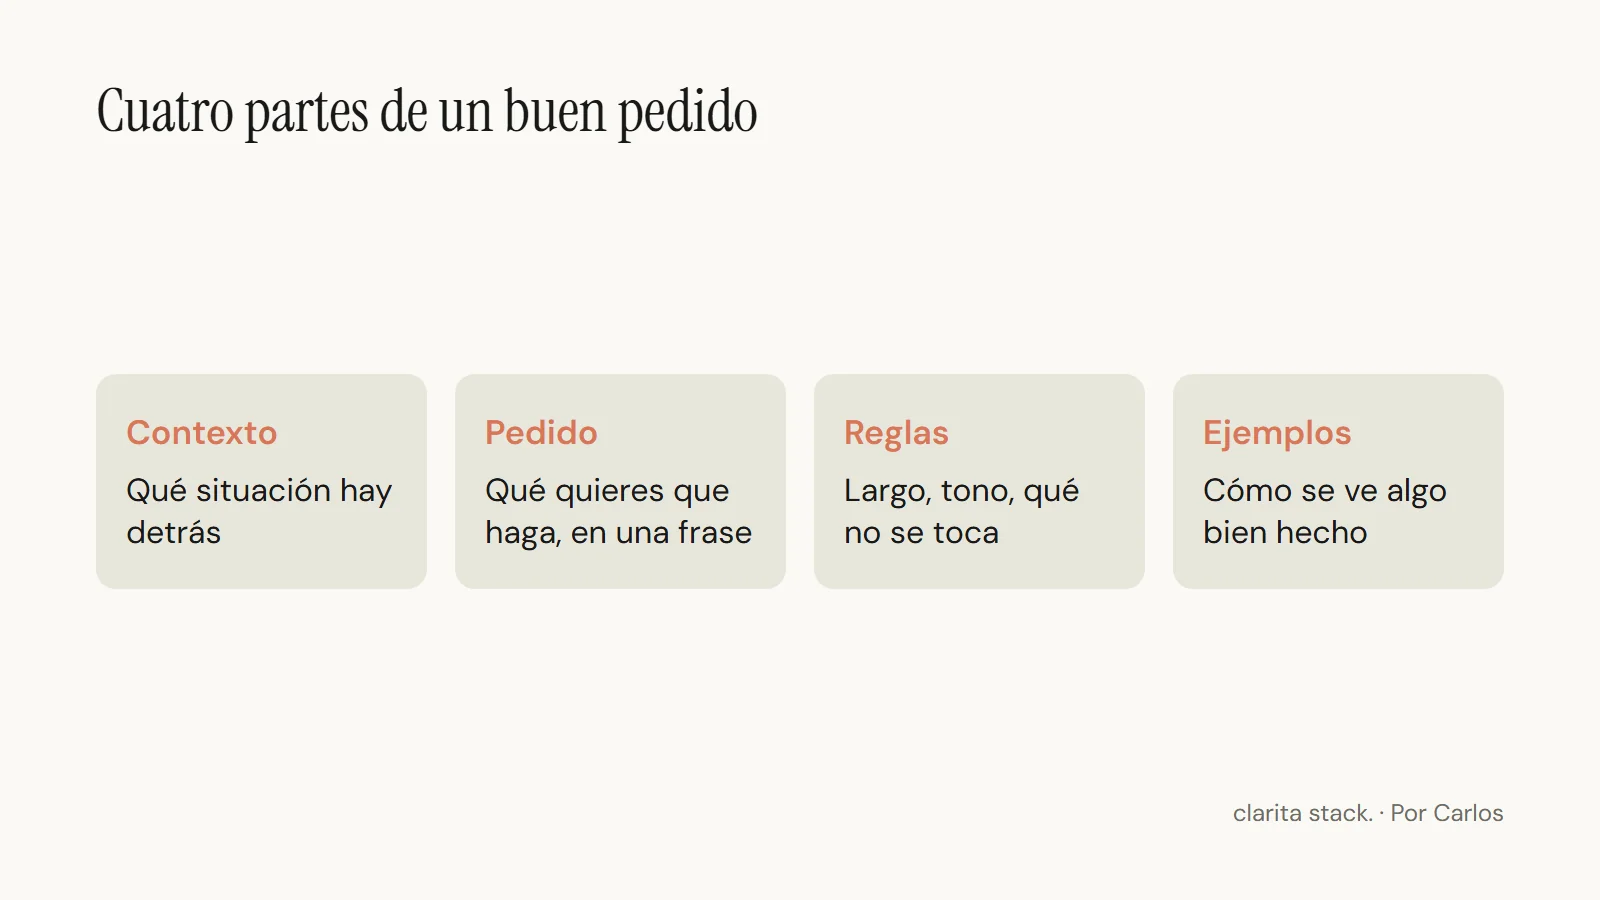
NN/g propone una estructura para pedir llamada CARE: contexto, pedido específico, reglas y ejemplos [C3]. Dicho en lenguaje de oficina:
- Contexto. Qué situación hay detrás. Quién va a leer esto, para qué, en qué punto del proceso estamos. Existe para que el agente no invente el marco.
- Pedido. Qué quieres que haga, en una frase que no admita dos lecturas. Es el corazón del encargo: sin esto, el resto flota.
- Reglas. Qué restricciones hay: largo, tono, qué no se menciona, qué datos no se tocan. Delimitan hasta dónde puede llegar la respuesta.
- Ejemplos. Cómo se ve algo bien hecho, o cómo se ve algo mal hecho. Anclan el criterio en algo concreto, no en adjetivos.
Nada de esto es técnico. Es lo que haces cuando delegas bien una tarea a una persona. La propia NN/g aclara el alcance: en una consulta general no hace falta tanto detalle; sí cuando buscas un resultado complejo o específico [C3]. Tampoco hay medición del efecto de CARE ni motivo para pensar que sea el único método posible. Es un marco de práctica, bien ordenado, y para este propósito alcanza.
Lo que sí importa es de dónde viene la precisión. No viene de saber qué es un modelo ni cómo se entrena. Viene de saber qué necesita el trabajo terminado y de ser capaz de ponerlo por escrito. Quien llevó equipos, atendió clientes o armó procesos durante años tiene esa musculatura. La herramienta es nueva; el ejercicio, no.
Pedir bien no alcanza: el otro lado
Hasta acá, la mitad cómoda de la tesis. La otra mitad es menos agradable: un pedido excelente no te exime de revisar lo que vuelve.
Voy a contar una cicatriz propia, y la cuento sin adornos. Por apuro, entregué una vez una presentación genérica sobre IA, sin contenido real. Me costó tiempo y un proyecto que quedó trunco. De ahí salió una regla que sigo usando: lo que no dominas y no revisaste no se entrega, aunque la IA lo haya dejado impecable.
Esa regla tiene una base más amplia que mi experiencia. Hay una literatura de factores humanos sobre el uso indebido de ayudas automáticas. Bahner, Hüper y Manzey lo definen como la confianza acrítica en el sistema sin reconocer sus límites, y describen el llamado error de comisión: seguir una recomendación automática aunque sea falsa, por no buscar información que la confirme o la contradiga [C4]. En su experimento, con 24 estudiantes de ingeniería en una simulación de control de procesos, hubo evidencia clara de complacencia —verificación insuficiente de la recomendación— y los errores de comisión se asociaron con niveles altos de ella. Los propios autores aclaran que el error es una consecuencia posible, no inevitable [C4].
Es una simulación industrial, con una muestra pequeña, anterior a la IA generativa. Lo uso como mecanismo general: cuando algo se ve competente, tendemos a mirar menos. Una revisión sistemática posterior encontró que el sesgo de automatización aparece también en tareas aisladas, típicamente de diagnóstico y con alta complejidad de verificación, aunque marca que la literatura es fragmentaria y que pocos estudios muestran significación frente a un control [C4]. No te digo que tu correo de las cuatro de la tarde corra el mismo riesgo que un operador de planta. Te digo que el mecanismo está documentado y que no hay motivo para creerse inmune.
La frontera irregular
Hay un segundo dato que cambia cómo conviene pensar la revisión. Un experimento de campo preregistrado de Harvard Business School con 758 consultores de BCG probó GPT-4 en tareas de trabajo intelectual. En 18 tareas dentro de lo que los autores llaman la «frontera» de la IA, quienes la usaron completaron 12,2 % más tareas, las hicieron 25,1 % más rápido y con una calidad más de 40 % superior frente al grupo de control [C6].
Hasta ahí, buena noticia. Pero los mismos investigadores diseñaron una tarea fuera de esa frontera, y ahí quienes usaron IA tuvieron 19 puntos porcentuales menos de probabilidad de dar una solución correcta que quienes no la usaron [C6]. Por eso hablan de una «frontera tecnológica irregular»: la IA rinde muy bien en algunas tareas y mal en otras que, desde afuera, parecen parecidas.
Es un working paper de 2023, con un solo modelo y una sola firma, y el paper declara que uno de sus autores es asesor de BCG en estrategia de IA. Los 19 puntos corresponden a una única tarea diseñada para quedar fuera de la frontera; no son un promedio de nada. Lo que sí deja el estudio es una consecuencia práctica: la frontera no se ve a simple vista, y por eso la revisión no se puede reservar «para cuando algo se vea raro».
Primero el criterio, después el pedido
Si la IA rinde de forma irregular [C6] y las personas tienden a seguir sin mirar [C4], quien pide necesita dos hábitos, y conviene ponerlos en este orden. Primero el sistema: antes de pedir, defines cómo vas a juzgar lo que vuelva. Después el proceso: el pedido. Al final, la herramienta.
Esto es un método para probar en tu escritorio. Ninguna de las fuentes de abajo demuestra que esta combinación mejore resultados de oficina; es una propuesta de oficio.
-
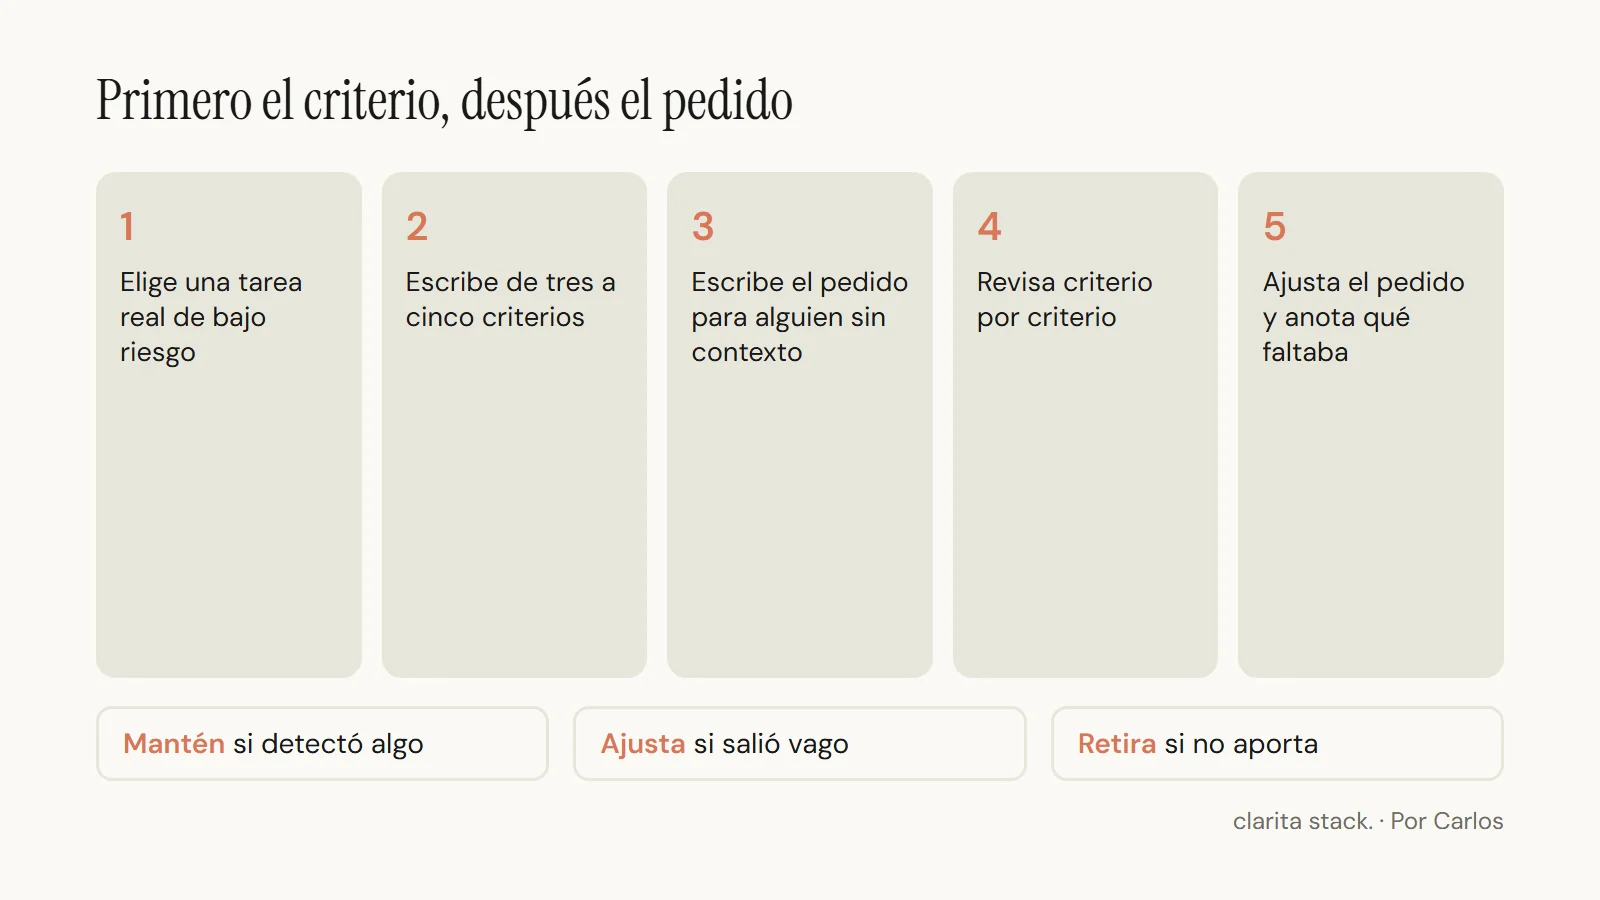
Elige una tarea real y de bajo riesgo. Un borrador de correo, el resumen de una planilla propia. Sin datos de clientes ni de personas. Por qué: si algo sale mal, el daño cabe en tu mesa. Alcance: si el resultado va a salir de tu oficina hacia un tercero, pasa por revisión humana completa, sin excepción.
-
Escribe antes los criterios de aceptación. Entre tres y cinco, en frases que se puedan contestar con sí o no: «menciona la fecha límite», «no promete nada que no esté en la planilla», «cabe en una pantalla». Por qué: escribirlos antes importa; después de leer un texto prolijo, cuesta mucho más ser exigente. Alcance: no es una rúbrica de veinte ítems; son los umbrales que cambian una decisión de aceptar o no.
-
Escribe el pedido para alguien sin contexto. Usa CARE [C3] y pasa la prueba del colega: si una persona que no conoce el tema se confundiría con tu pedido [C1], reescríbelo. Por qué: el agente no pregunta; rellena. Alcance: en consultas generales no hace falta tanto detalle [C3]; sí cuando el resultado es complejo o específico.
-
Revisa el resultado contra tus criterios, uno por uno. No contra una impresión general. Cada criterio que falla es información sobre el pedido o sobre la tarea. Por qué: saber que debes revisar no es lo mismo que revisar [C5]. Alcance: ajusta la profundidad al riesgo; un borrador interno merece menos que un texto que firma tu nombre ante un cliente.
-
Ajusta el pedido y anota qué faltaba. Esa nota es el activo: con el tiempo se vuelve una lista de criterios que se repiten y que puedes reutilizar. Por qué: el valor no está en una sola corrida, sino en lo que aprendes a pedir y a exigir. Alcance: si después de varias tareas la lista no te enseñó nada nuevo, retira la rutina.
La evidencia de logro es modesta y concreta: un pedido escrito y una lista de criterios que sirven para la próxima vez. Nada de esto promete ahorrar tiempo ni mejorar resultados; promete que sabrás qué aceptaste y por qué.
Por qué el criterio va por escrito
Un criterio que vive en tu cabeza se adapta a lo que tienes delante. Cuando el texto llega bien presentado, la vara tiende a bajar sola; ese es el mecanismo que describe [C4]. Un criterio escrito antes no negocia.
Hay además un matiz sobre cómo advertirte a ti mismo. Bahner y sus colegas recuerdan, citando a Skitka y coautores (2000), que solo informar sobre la fiabilidad limitada de un sistema y recomendar que se verifique no reduce lo suficiente el sesgo de automatización [C5]. Dicho sin rodeos: saber que debes revisar no es lo mismo que revisar. Lo que sí redujo la complacencia de manera significativa en su experimento fue exponer a los operadores a fallas de la automatización durante el entrenamiento, aunque quizá no la evite del todo [C5].
La traducción a tu escritorio es una inferencia mía, no un resultado: si ver fallar a la herramienta entrena la vigilancia, vale la pena que tus primeras tareas con un agente sean de bajo riesgo y que anotes las veces que se equivocó. Ese registro es tu propio entrenamiento. Y de nuevo el límite: esto se midió en una simulación industrial con pocas personas, no con IA generativa en una oficina [C5].
Qué no resuelve este método
Tres aclaraciones para que no se lea como más de lo que es.
Un buen pedido no elimina la revisión. Pedir bien reduce idas y vueltas [C2], pero la frontera irregular [C6] significa que un pedido impecable sobre una tarea que la IA maneja mal sigue dando un mal resultado, con buena presentación.
Revisar no es sospechar de todo. Revisar cada línea con lupa tiene su costo, y no tengo una fuente que mida el exceso de revisión. Lo único que veo en la evidencia leída es que el sesgo aparece sobre todo cuando verificar es costoso y la carga mental es alta [C4]. Mi criterio, que es de oficio y no científico: ajusta la profundidad de la revisión al riesgo de la tarea. Un borrador interno merece menos que un texto que firma tu nombre ante un cliente.
Saber programar no te da esta ventaja. Tampoco te la quita. Pero la precisión que describo sale de explicar contexto, pedido, reglas y ejemplos [C3], y esas son habilidades de gestión. Si diriges personas, ya llevas años practicándolas, aunque nunca las hayas llamado así.
Quedan fuera, a propósito, el prompting avanzado, la programación y la comparación de herramientas. Hay muchas guías de eso; ninguna sustituye el criterio sobre qué se pide y cómo se acepta.
Mantén, ajusta o retira
Cuando hayas hecho el ejercicio con una primera tarea, decide con tres preguntas:
- Mantén el método si tu lista de criterios detectó al menos un problema que habrías dejado pasar, o si el pedido escrito para un colega sin contexto te obligó a aclarar algo que no tenías claro. Repite con una segunda tarea y compara qué criterios se repiten: esos son los que valen la pena guardar.
- Ajusta si los criterios te salieron vagos («que quede bien») o demasiados para revisarlos con honestidad. Reduce a los que realmente cambian una decisión.
- Retira el método de las tareas donde no aporta: consultas generales donde el costo de equivocarte es mínimo [C3]. No todo merece un pedido de cuatro partes ni una lista de criterios.
Y si después de varias tareas la lista no te enseñó nada que no supieras, retira la rutina. Eso también es un resultado.
Ahora elige una tarea chica
Elige una tarea chica de tu propia mesa. Escribe tres criterios antes de pedirla. Compara el resultado contra ellos. Guarda el pedido y la lista. Es todo.
Dónde termina la evidencia
Esta es una tesis de oficio, no una ley. C1 es guía de un proveedor; C2 y C3, observación y marco de práctica de NN/g con muestras o sin medición de efecto; C4 y C5, un experimento industrial de 2008 con 24 estudiantes y una revisión sistemática que marca literatura fragmentaria; C6, un working paper de 2023 con un modelo, una firma y una tarea fuera de frontera. La combinación «criterio escrito + pedido preciso + revisión uno a uno» es propuesta mía: ninguna fuente la mide en trabajo de oficina.
Por Carlos · clarita stack.
Fuentes
- [C1] Anthropic, Prompting best practices, sección «Be clear and direct». https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
- [C2] Budiu, Liu, Zhang y Cionca, Prompt Structure in Conversations with Generative AI, Nielsen Norman Group (24/11/2023). https://www.nngroup.com/articles/ai-prompt-structure/
- [C3] Moran, CARE: Structure for Crafting AI Prompts, Nielsen Norman Group (24/05/2024). https://www.nngroup.com/articles/careful-prompts/
- [C4] Bahner, Hüper y Manzey, Misuse of automated decision aids: Complacency, automation bias and the impact of training experience, International Journal of Human-Computer Studies 66(9) (2008); y Lyell y Coiera, JAMIA 24(2) (2016). https://www.sciencedirect.com/science/article/abs/pii/S1071581908000724 · https://pmc.ncbi.nlm.nih.gov/articles/PMC7651899/
- [C5] Bahner, Hüper y Manzey (2008), con cita de Skitka et al. (2000b). https://www.sciencedirect.com/science/article/abs/pii/S1071581908000724
- [C6] Dell'Acqua et al., Navigating the Jagged Technological Frontier, Harvard Business School Working Paper 24-013 (2023). https://mitsloan.mit.edu/sites/default/files/2023-10/SSRN-id4573321.pdf